カスタム消費ログ
ダウンロード
フォーカスモード
フォントサイズ
カスタム消費の仕組み
カスタム消費はCLSが自社開発したSDKであり、クラウドからログデータを効率的に取得・処理することを目的としています。その中核メカニズムは、コンシューマーグループを利用した協調動作にあり、サーバー側で自動管理されるCLBの原理によって、コンシューマー数やログパーティションに変化が生じた際にタスクを動的に割り当て、データ処理の連続性と重複排除を確保します。高い信頼性と拡張性を備えたログリアルタイム消費フレームワークです。
コンシューマーグループの消費フロー
コンシューマーグループを使用してデータを消費する際、サーバー側はコンシューマーグループ内のすべてのコンシューマーの消費タスクを管理し、トピックパーティションとコンシューマー数の関係に基づいて消費タスクの均衡性を自動的に調整します。また、各トピックパーティションの消費進捗を記録し、異なるコンシューマーがデータを重複なく消費できるようにします。コンシューマーグループによる消費の具体的なフローは以下の通りです:
1. コンシューマーグループを作成します。
2. 各コンシューマーは定期的にサーバーへハートビートを送信します。
3. コンシューマーグループは、トピックパーティションの負荷状況に応じて、トピックパーティションをコンシューマーに自動的に割り当てます。
4. コンシューマーは、割り当てられたパーティションリストに基づいて、パーティションのoffsetを取得し、データを消費します。
5. コンシューマーはパーティションの消費進捗をコンシューマーグループへ定期的に更新し、次回のコンシューマーグループによるタスク割り当てを容易にします。
6. 手順2~手順6を、消費が終了するまで繰り返します。
CLB消費の仕組み
コンシューマーグループは、アクティブなコンシューマーとトピックパーティションの数に基づいて各コンシューマーの消費タスクを動的に調整し、消費の均衡性を保ちます。また、コンシューマーは各トピックパーティションの消費進捗を保存し、障害復旧後もデータを継続して消費できるようにし、重複消費を回避します。
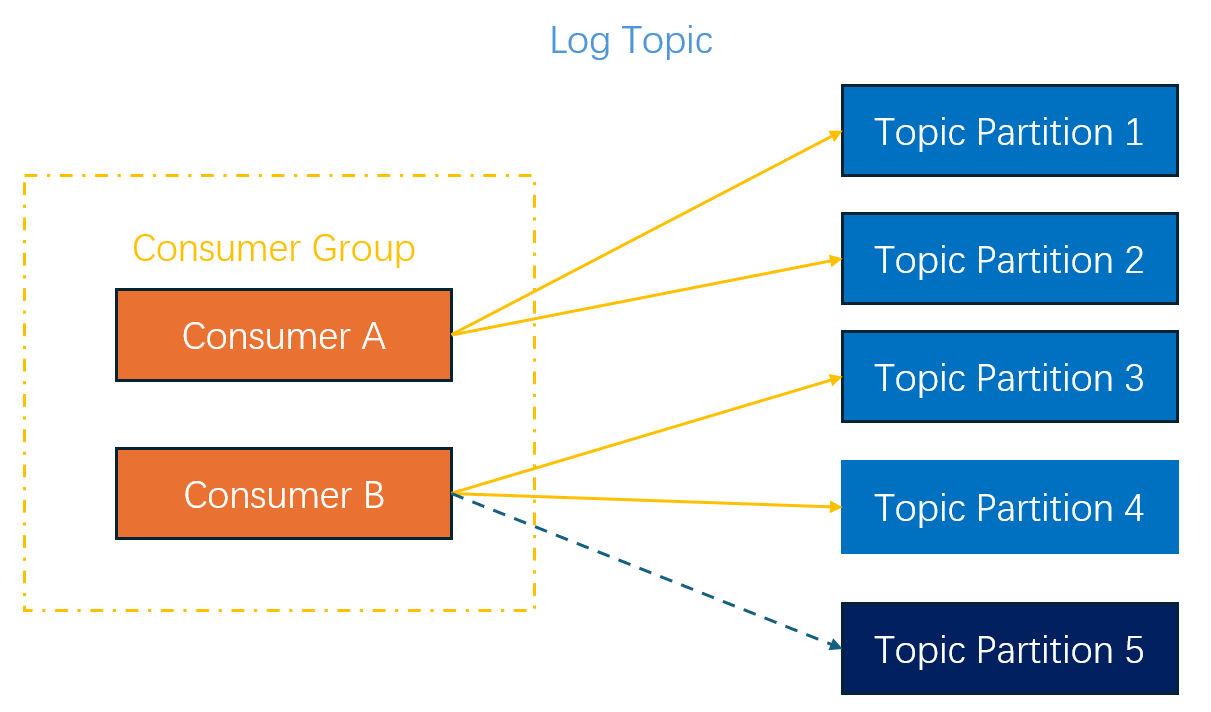
例1:トピックパーティションの変更
例えば、あるログトピックに2つのコンシューマーがあり、コンシューマーAはパーティション1、2を消費し、コンシューマーBはパーティション3、4を消費します。分割操作によってトピックパーティション5を新規追加した後、コンシューマーグループは自動的にパーティション5をコンシューマーBに割り当てて消費させます。以下の図に示す通りです:
例2:コンシューマーの変更
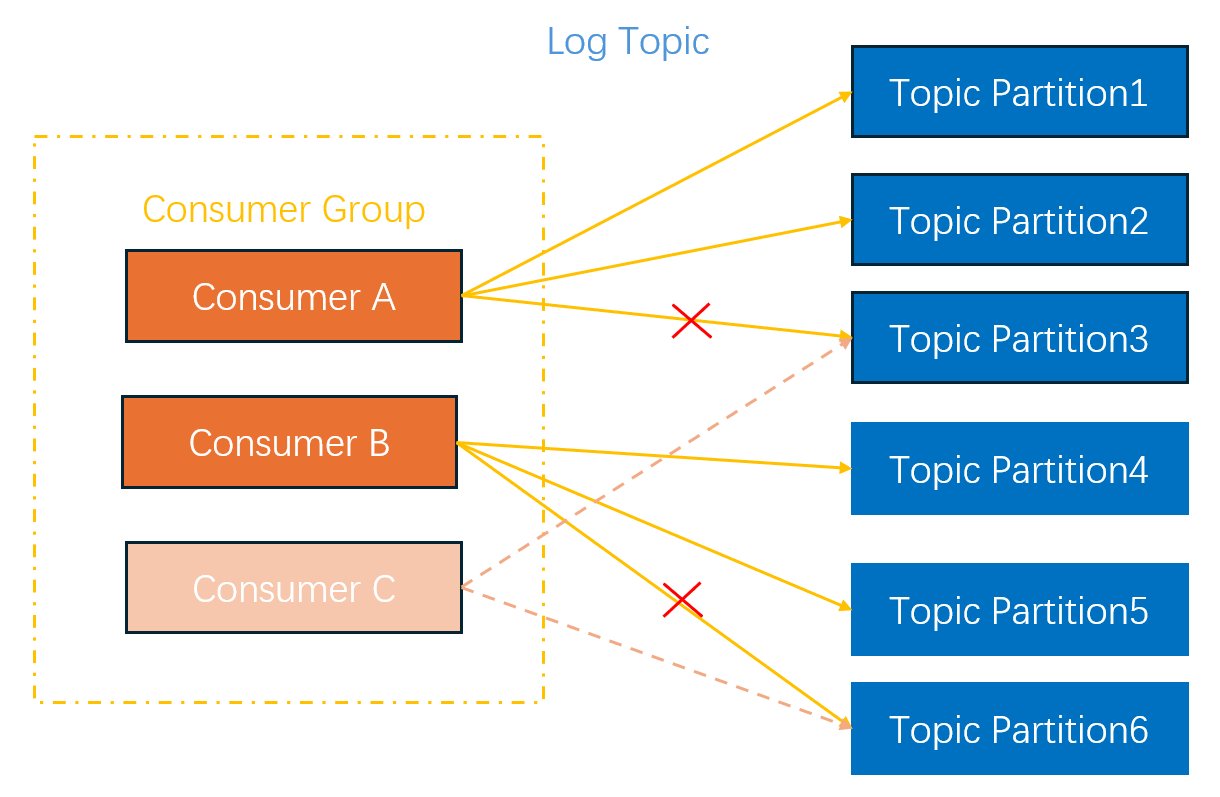
例えば、あるログトピックに2つのコンシューマーがあり、コンシューマーAはパーティション1、2、3を消費し、コンシューマーBはパーティション4、5、6を消費します。新しいコンシューマーCを追加すると、コンシューマーグループは再均衡分配を行い、パーティション3、6を新しいコンシューマーCに割り当てて消費させます。以下の図に示す通りです:
カスタム消費の使用
前提条件
サブアカウント/コラボレーターはメインアカウントの承認が必要です。承認手順についてはCAMに基づく権限管理を、承認ポリシーのコピーについてはCLSアクセスポリシーテンプレートを参照してください。
操作手順
1. SDKをインストールします。詳細についてはtencentcloud-cls-sdk-pythonを参照してください。
pip install git+https://github.com/TencentCloud/tencentcloud-cls-sdk-python.git
2. コンシューマーを作成してコンシューマースレッドを起動します。このコンシューマーは指定されたトピックからデータを消費します。消費Demo-消費プリフィルタリングを参照してください。このDemoは、ログを先にフィルタリングしてから消費する例を示しています。コンシューマーグループのConsumerにフィルタ条件
log_keep(op_and(op_gt(v("status"), 400), str_exist(v("cdb_message"), "pwd")))を追加することで、[ステータスコードが400より大きく、かつcdb_messageフィールドに「pwd」文字列が含まれる]ログのみを消費できます。
コンシューマーパラメータの説明
は以下の通りです:設定パラメータ | 必須/任意 | 説明 | デフォルト値 | 値の範囲 |
endpoint | はい | - | サポート対象リージョン:ALL | |
access_key_id | はい | - | - | |
access_key | はい | - | - | |
region | はい | - | サポート対象リージョン:ALL | |
logset_id | はい | ログセットIDです。1つのログセットのみサポートされます。 | - | - |
topic_ids | はい | 日志主题 ID。複数のトピックを使用する場合は、「,」で区切ってください。 | - | - |
consumer_group_name | はい | コンシューマーグループ名です。 | - | - |
internal | いいえ | 内部ネットワーク:TRUE 公衆ネットワーク:FALSE 説明: | FALSE | TRUE/FALSE |
consumer_name | はい | コンシューマー名です。同じコンシューマーグループ内で、コンシューマー名は重複できません。 | - | 0-9、aA-zZ、'-'、'_'、'.'で構成される文字列 |
heartbeat_interval | いいえ | コンシューマーのハートビート報告間隔です。2間隔の間にハートビートが報告されない場合、コンシューマーはオフラインと見なされます。 | 20 | 0~30分 |
data_fetch_interval | いいえ | コンシューマーがデータを取得する間隔です。1秒以上である必要があります。 | 2 | - |
offset_start_time | いいえ | データ取得の開始時刻です。文字列型のUNIXタイムスタンプで、精度は秒単位です。例えば「1711607794」です。「begin」「end」を直接設定することもできます。 begin:ログトピックのライフサイクルにおける最も古いデータです。 end:ログトピックのライフサイクルにおける最新のデータです。 | "end" | 「begin」/「end」/UNIXタイムスタンプ |
max_fetch_log_group_size | いいえ | コンシューマーが1回に取得するデータサイズです。デフォルトは2M、最大は10Mです。 | 2097152 | 2M - 10M |
offset_end_time | いいえ | データ取得の終了時刻です。文字列型のUNIXタイムスタンプに対応しており、精度は秒単位です。例えば「1711607794」です。未入力の場合は継続的に取得します。 | - | - |
query | いいえ | 説明: 一部のデータ加工関数のみをサポートします。 | log_keep(op_and(op_gt(v("status"), 400), str_exist(v("message"), "access failed"))) statusフィールドが400より大きく、かつmessageフィールドに「access failed」キーワードが含まれるログのみを消費します。 | - |
注意:
消費開始時間:指定した時点(例:offset_start_time=1711607794)から1回消費した場合、再度その時点から消費を開始するには、コンシューマーグループの名前を変更してください。
フィードバック