インデックス設定
ダウンロード
フォーカスモード
フォントサイズ
操作シナリオ
インデックス設定は、CLS(Cloud Log Service)を使用して検索分析を行うための必要条件です。インデックスを有効にした場合のみ、ログの検索分析が可能になります。また、インデックスルールが異なると、ログの検索分析効果も異なります。本書では、インデックスの設定ルールと仕組みについて詳しく説明します。
機能説明
インデックス設定の核心は、元のログに対して「分かち書き」を行い、特定の検索条件に基づいて迅速かつ容易にログを検索することです。また、インデックス設定では、特定のフィールドに対して「統計を有効化」することもでき、SQLを使用してログを統計分析するのに便利です。
長いログを検索する場合、通常はその一部の内容のみを使用して検索します。例えば、
sampleを含む以下の完全なログを検索する必要があります:10.20.20.10;[2018-07-16 13:12:57];GET /online/sample HTTP/1.1;200
ログ全文が非常に長く、
sample以外にも多くの内容が含まれており、検索条件と直接等しいわけではないため、sampleを検索条件として直接使用してこのログを検索することはできません。この検索要件を満たすために、ログ全文を複数の断片に分割する必要があります。各断片を「単語」と呼び、このプロセスを「分かち書き」と呼びます。例えば、上記のサンプルログを記号で分割します。
@&()='",;:<>[]{}/ \\n\\t\\r\\\\の範囲内の記号が現れたら、ログを分割し、以下の単語が得られます: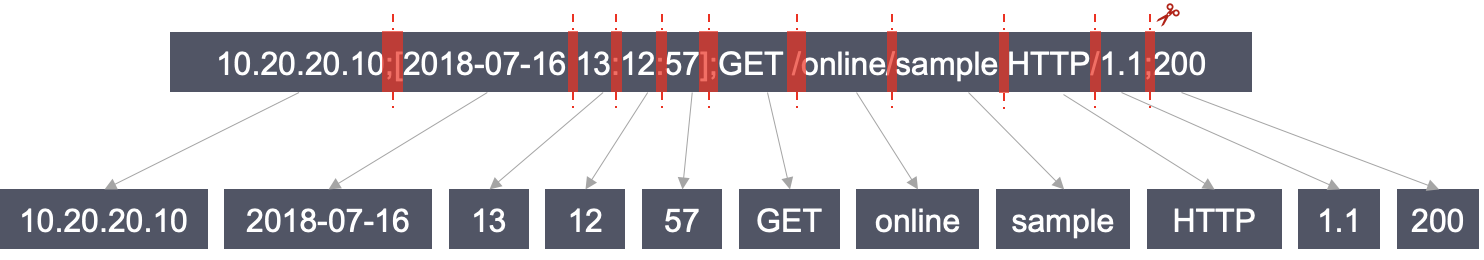
検索条件が
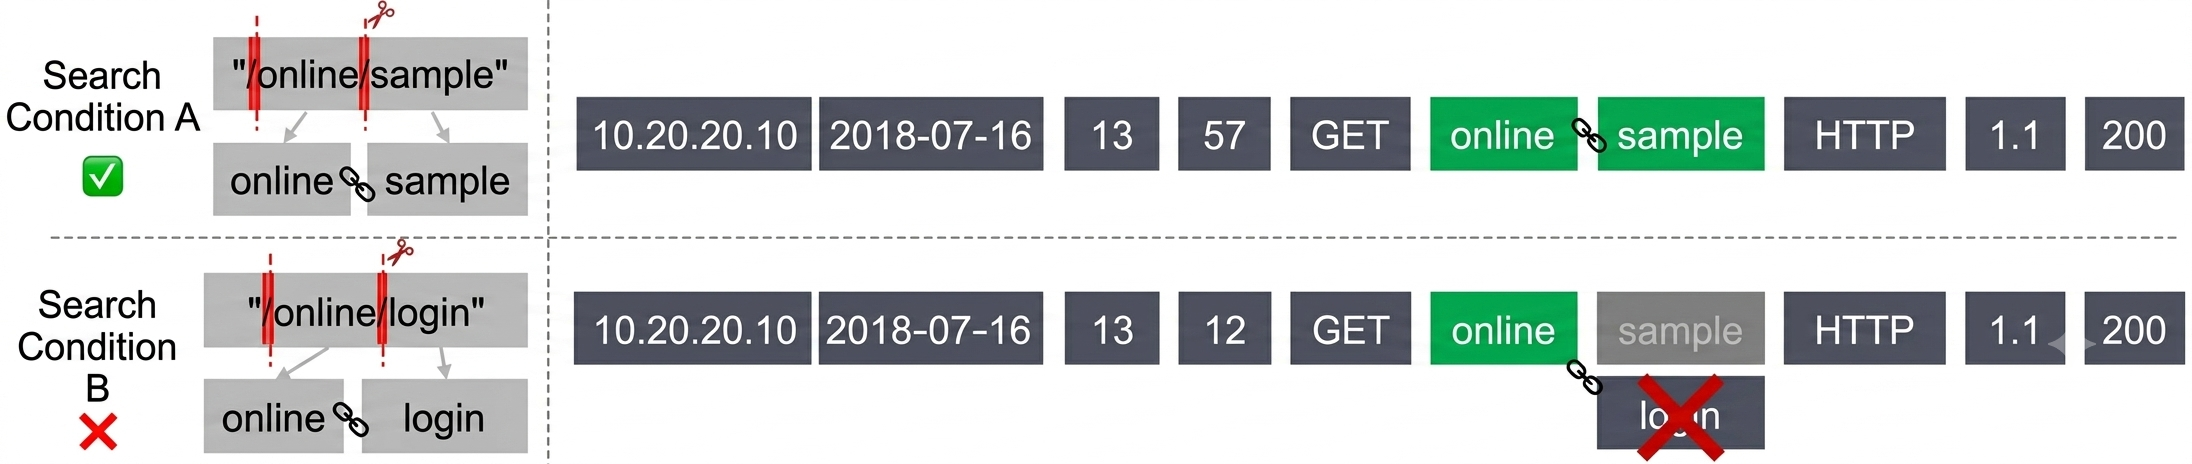
sampleである場合、上記の分かち書き後のログにsampleが含まれていれば、検索条件を満たしていると見なされます。検索条件自体も分かち書きが行われます。例えば、以下の図の2種類の検索条件です:
検索条件A:
"/online/sample"二重引用符は、ログに同時に存在するこれら2つの語が必要であり、かつ2つの語の順序が厳密に一致する場合にのみ検索条件を満たすことを示します。
上記のサンプルログは
onlineとsampleを同時に含み、かつ語の順序が検索条件と一致するため、この検索条件を満たしています。検索条件B:
"/online/login"上記のサンプルログには
loginが含まれておらず、この検索条件を満たしません。CLSには以下の2種類のインデックスが含まれています:
カテゴリ | 説明 |
全文インデックス | 全文インデックスはログ全文を複数の分詞に分割してインデックスを構築します。検索時はキーワードで直接検索します(全文検索)。例えば、 errorを使用して、errorが出現したすべてのログを検索します。 |
キーバリューインデックス | キーバリューインデックスは、元のログをフィールド(つまり key:value)ごとに複数のトークンに分割してインデックスを構築します。検索時はキーバリュー方式で検索します(つまりキーバリュー検索)。例えば、 level:error AND timeCost:>1000を使用して、ログレベル(level)が error で、かつ処理時間(timeCost)が1000msより大きいログを検索します。 |
注意:
インデックス設定は比較的複雑なため、操作手順の推奨設定を使用することをお勧めします。ほとんどの利用ニーズを満たすことができます。
インデックスが無効な間に収集されたログデータは検索できません。インデックスを有効にしてからログの検索分析が可能になるまで、約1分の遅延があります。
インデックスルールの編集(フィールドの追加・編集・削除、単語区切り文字設定の調整などを含むすべての操作)後は、新しく書き込まれたログにのみ適用され、既存データは更新されません。
下線で始まるものはシステムで予約された用途です。ログに下線で始まるフィールドが含まれている場合、インデックスを有効にすると、フィールドの前に@記号が付加されます。
低頻度ストレージは全文インデックスのみをサポートし、キー値インデックスはサポートしません。
全文インデックス
設定項目 | 機能説明 |
全文分かち書き文字 | 元のログを単語分割するための文字集合です。英語の記号のみをサポートします。コンソールのデフォルトの単語分割記号は @&?|#()='",;:<>[]{}/ \\n\\t\\r\\\\です。 |
大文字と小文字の区別 | 検索時に大文字と小文字を区別するかどうかを設定します。例えば、ログが Error の場合、大文字と小文字を区別する設定では、error を使用してそのログを検索することはできません。 |
中国語を含むかどうか | ログに中国語が含まれており、中国語で検索する必要がある場合にこの機能を有効にできます。例えば、ログが「ユーザーログインインターフェースタイムアウト」の場合、この機能を有効にしていないと、 「タイムアウト」を検索してもそのログを検索できません。完全に「ユーザーログインインターフェースタイムアウト」を検索した場合のみ、そのログを検索できます。この機能を有効にした後は、「タイムアウト」を検索することでそのログを検索できます。 |
キーバリューインデックス
設定項目 | 機能説明 | |
全体設定 | 大文字と小文字の区別 | 検索時に大文字と小文字を区別するかどうかを設定します。例えば、ログが「level:Error」の場合、大文字と小文字を区別する設定では、 level:errorを使用してそのログを検索することはできません。 |
| 自動設定 | 键值索引の自動設定を有効にするかどうかを指定します。有効にすると、ログ内のフィールドが自動的に键值索引に追加されます。これには、後からログに追加されたフィールドも含まれます。フィールド追加ルールについては、自動設定を参照してください。 |
フィールド設定 | フィールド名称 | 構造化ログ内のフィールド名です。1つのログトピックのキー値インデックスには、最大300個のフィールドを追加できます。 *\\",を除くすべての英文字、記号および数字をサポートします。ただし、_で始めることはできません(__CONTENT__フィールドは例外です)。フィールドタイプにjsonが存在しない場合、親子フィールドを同時に含めることはできません。例えば、 aおよびa.bです。 |
| フィールド別名 | 元のフィールド名の代わりにエイリアスを使用して検索分析を行います。例えば、 __SOURCE__フィールドにエイリアスipを追加します。エイリアスは英文字、数字、下線のみをサポートし、かつ英文字で始まる必要があります。 CQL構文のみをサポートし、Lucene構文はサポートしません。 |
| フィールドタイプ | フィールドのデータ型には、text、long、double、jsonの4種類があります。 text型とjson型はワイルドカードを使用したあいまい検索をサポートしますが、範囲比較はサポートしません。 long型とdouble型は範囲比較をサポートしますが、あいまい検索はサポートしません。 json型を使用する場合、子フィールドを追加できます。子フィールドはtext型、long型、double型に設定するか、またはjson型を引き続き使用してより深い階層のフィールドを追加できます。 説明: json型は現在、一部のユーザーまたはログトピックのみでサポートされています。ご利用が必要な場合は、お問い合わせの上、機能の許可リストを有効にしてください。 インデックス設定にjson型が存在する場合、 a.b形式のフィールド名は、ログフィールド名が文字列a.bであることを厳密に表し、aオブジェクトの子フィールドbを表すことはありません。 |
| 分かち書き文字 | フィールド値を単語分割するための文字集合です。英語の記号のみをサポートします。コンソールのデフォルトの単語分割記号は @&?|#()='",;:<>[]{}/ \\n\\t\\r\\\\です。 |
| 中国語を含む | フィールドに中国語が含まれており、中国語で検索する必要がある場合にこの機能を有効にできます。例えば、ログが「message:ユーザーログインインターフェースタイムアウト」の場合、この機能を有効にしていないと、 message:「タイムアウト」ではそのログを検索できません。完全にmessage:「ユーザーログインインターフェースタイムアウト」を使用した場合のみ、そのログを検索できます。この機能を有効にした後は、message:「タイムアウト」でそのログを検索できます。 |
| 統計を有効にする | 有効にすると、そのフィールドに対してSQLで統計分析を実行できます。text型フィールドで統計を有効にした場合、値が長すぎると、先頭の32766文字のみが統計演算に使用されます。 統計を有効にしても追加料金は発生しません。有効にすることをお勧めします。 |
説明:
全文インデックスが有効な場合、キー値インデックスは追加のインデックストラフィック/ストレージ費用を発生させません。より良い検索・分析エクスペリエンスを得るために、できるだけ多くのフィールドでキー値インデックスを有効にすることをお勧めします。
最も基本的なログ検索要件を満たすために、CLSはログ内の一部の組み込み予約フィールドに対してキー値インデックスを自動的に作成します。ただし、インデックストラフィックは発生せず、費用も増加しません。具体的には以下の通りです:
内置保持フィールド | 説明 | キーバリューインデックス設定 |
__FILENAME__ | ログ収集のファイル名です。このフィールドを使用して特定のファイル内のログを検索できます。例えば、 __FILENAME__:"/var/log/access.log"は/var/log/access.logファイルのログを検索します。 | text型、区切り文字なし、中国語を含まない、統計を有効にしました。 |
__SOURCE__ | ログ収集のソースIPです。このフィールドを使用して特定のマシン内のログを検索できます。例えば、 __SOURCE__:192.168.10.10は192.168.10.10マシンのログを検索します。 | text型、区切り文字なし、中国語を含まない、統計を有効にしました。 |
__HOSTNAME__ | ログソースマシン名です。このフィールドを使用して特定のマシン内のログを検索できます。例えば、 __HOSTNAME__:localhost は localhost マシンのログを検索します。注意:バージョン2.7.4以降のLoglistenerを使用している場合のみ、このフィールドが収集されます。 | text型、区切り文字なし、中国語を含まない、統計を有効にしました。 |
__TIMESTAMP__ | ログタイムスタンプ(ミリ秒単位のUnixタイムスタンプ)は、時間範囲でログを検索する際に自動的に使用され、検索ステートメントで指定する必要はありません。コンソールでは「ログ時間」と表示されます。 | long型、統計を有効にしました。 |
__INDEX_STATUS__ | __INDEX_STATUS__:*を使用すると、インデックス作成に異常があるすべてのログを検索できます。 | text型、区切り文字なし、中国語を含まない、統計を有効にしました。 |
自動設定
自動設定スイッチを有効にすると、ログ内のフィールドがキー値インデックスに自動的に追加されます。これにはログ内で新しく追加されたフィールドも含まれます。
フィールドを追加する際、フィールド値に基づいてフィールド型を自動的に判定し、フィールド型をtext、long、またはdoubleに設定し、以下の設定を使用します。以下の設定が使用要件を満たさない場合(例えばフィールド型が正しくない場合)、追加後にフィールド上で手動で変更できます。
フィールドタイプ | トークン区切り文字 | 中国語を含む | 統計を有効化 |
text | @&?|#()='",;:<>[]{}/ \\n\\t\\r\\\\ | 含む | オン |
long | 該当なし | 該当なし | オン |
double | 該当なし | 該当なし | オン |
説明:
日志字段名は、アルファベット、数字、アンダースコア、および-./@のみをサポートし、アンダースコアで始めることはできません。この規則に準拠しないフィールドはキー値インデックスに追加されません。
ログフィールドがjson文字列の場合、デフォルトではjsonは解析されません。json内の子フィールドをキー値インデックスに追加する必要がある場合は、その中の任意の子フィールドを手動で追加してください。その後、その子フィールドと同じ階層のフィールドが自動的にキー値インデックスに追加されます。また、フィールド型をjsonに変更すると、現在のjsonフィールドとその子フィールド(1階層)が自動的にキー値インデックスに追加されます。
説明:
例えば元のログには合計3つのフィールドがあります:
key1:textValuekey2:123key3:{"ip":"123.123.123.132","url":"class/132.html","detail":{"status_code":"500","id":13}}
自動的に追加されるキー値インデックスは以下の通りです:
フィールド名称 | フィールドタイプ | トークン区切り文字 | 中国語を含む | 統計を有効化 |
key1 | text | @&?|#()='",;:<>[]{}/ \\n\\t\\r\\\\ | 含む | オン |
key2 | long | 該当なし | 該当なし | オン |
key3 | text | @&?|#()='",;:<>[]{}/ \\n\\t\\r\\\\ | 含む | オン |
フィールドkey3を手動でkey3.ipに変更すると、ipと同じ階層のフィールドurlおよびdetailがキー値インデックスに自動的に追加されます:
フィールド名称 | フィールドタイプ | トークン区切り文字 | 中国語を含む | 統計を有効化 |
key1 | text | @&?|#()='",;:<>[]{}/ \\n\\t\\r\\\\ | 含む | オン |
key2 | long | 該当なし | 該当なし | オン |
key3.ip | text | @&?|#()='",;:<>[]{}/ \\n\\t\\r\\\\ | 含む | オン |
key3.url | text | @&?|#()='",;:<>[]{}/ \\n\\t\\r\\\\ | 含む | オン |
key3.detail | text | @&?|#()='",;:<>[]{}/ \\n\\t\\r\\\\ | 含む | オン |
詳細設定
一部の特殊な利用シーンに対応するため、インデックス設定では以下の詳細設定を提供します。実際の利用時には、推奨設定を採用することをお勧めします。コンソールからインデックス設定を新規作成する際も、デフォルトで推奨設定が採用されます。
設定項目 | 意味 | 推奨設定 |
組み込み予約フィールドを全文インデックスに含めます。 | 含む:全文インデックスには __FILENAME__、__HOSTNAME__、および__SOURCE__の3つの組み込みフィールドが含まれます。また、全文検索とキー値検索の両方をサポートします。例えば"/var/log/access.log"、__FILENAME__:"/var/log/access.log"です。含まない:全文インデックスには上記の3つの組み込みフィールドは含まれず、キー値検索のみを使用できます。例えば __FILENAME__:"/var/log/access.log"です。 | 含む |
メタデータフィールドを全文インデックスに含めます。 | 含む:全文インデックスにはすべてのメタデータフィールド(プレフィックスが __TAG__のフィールド)が含まれます。全文検索を使用して、関連するログフィールドを直接検索できます。例えばap-beijingです。含まない:全文インデックスにはメタデータフィールドが一切含まれず、キー値検索を使用してのみ関連ログフィールドを検索できます。例えば __TAG__.region:ap-beijingです。低頻度ログトピックはキー値検索をサポートしていないため、この場合これらのフィールドを検索することはできません。キー値インデックスが有効なメタデータフィールドのみを含む:全文インデックスには、キー値インデックスが有効なメタデータフィールドが含まれ、キー値インデックスが無効なメタデータフィールドは含まれません。低頻度ログトピックにはこのオプションはありません。 | 含む |
ログのインデックス作成異常時の保存ルール | ログインデックス作成中に異常が発生した場合、CLSはログの欠落を防ぐため、元のログを __RAWLOG__に保存します。このとき一部のフィールドのみインデックス作成に失敗した場合、失敗した部分を指定のフィールドに保存できます(デフォルトはRAWLOG_FAIL_PART)。詳細はインデックス作成の異常とは何ですかをご参照ください。 | 有効 |
操作手順
インデックス設定の編集
1. CLSコンソールにログインします。
2. 左側のナビゲーションバーでログトピックをクリックし、ログトピックリストページに移動します。
3. インデックスを設定する必要があるログトピックのID/名前をクリックし、ログトピック管理ページに移動します。
説明:
初めてインデックス設定を有効にする場合、
推奨設定を使用して、インデックスの自動設定を完了することをお勧めします。
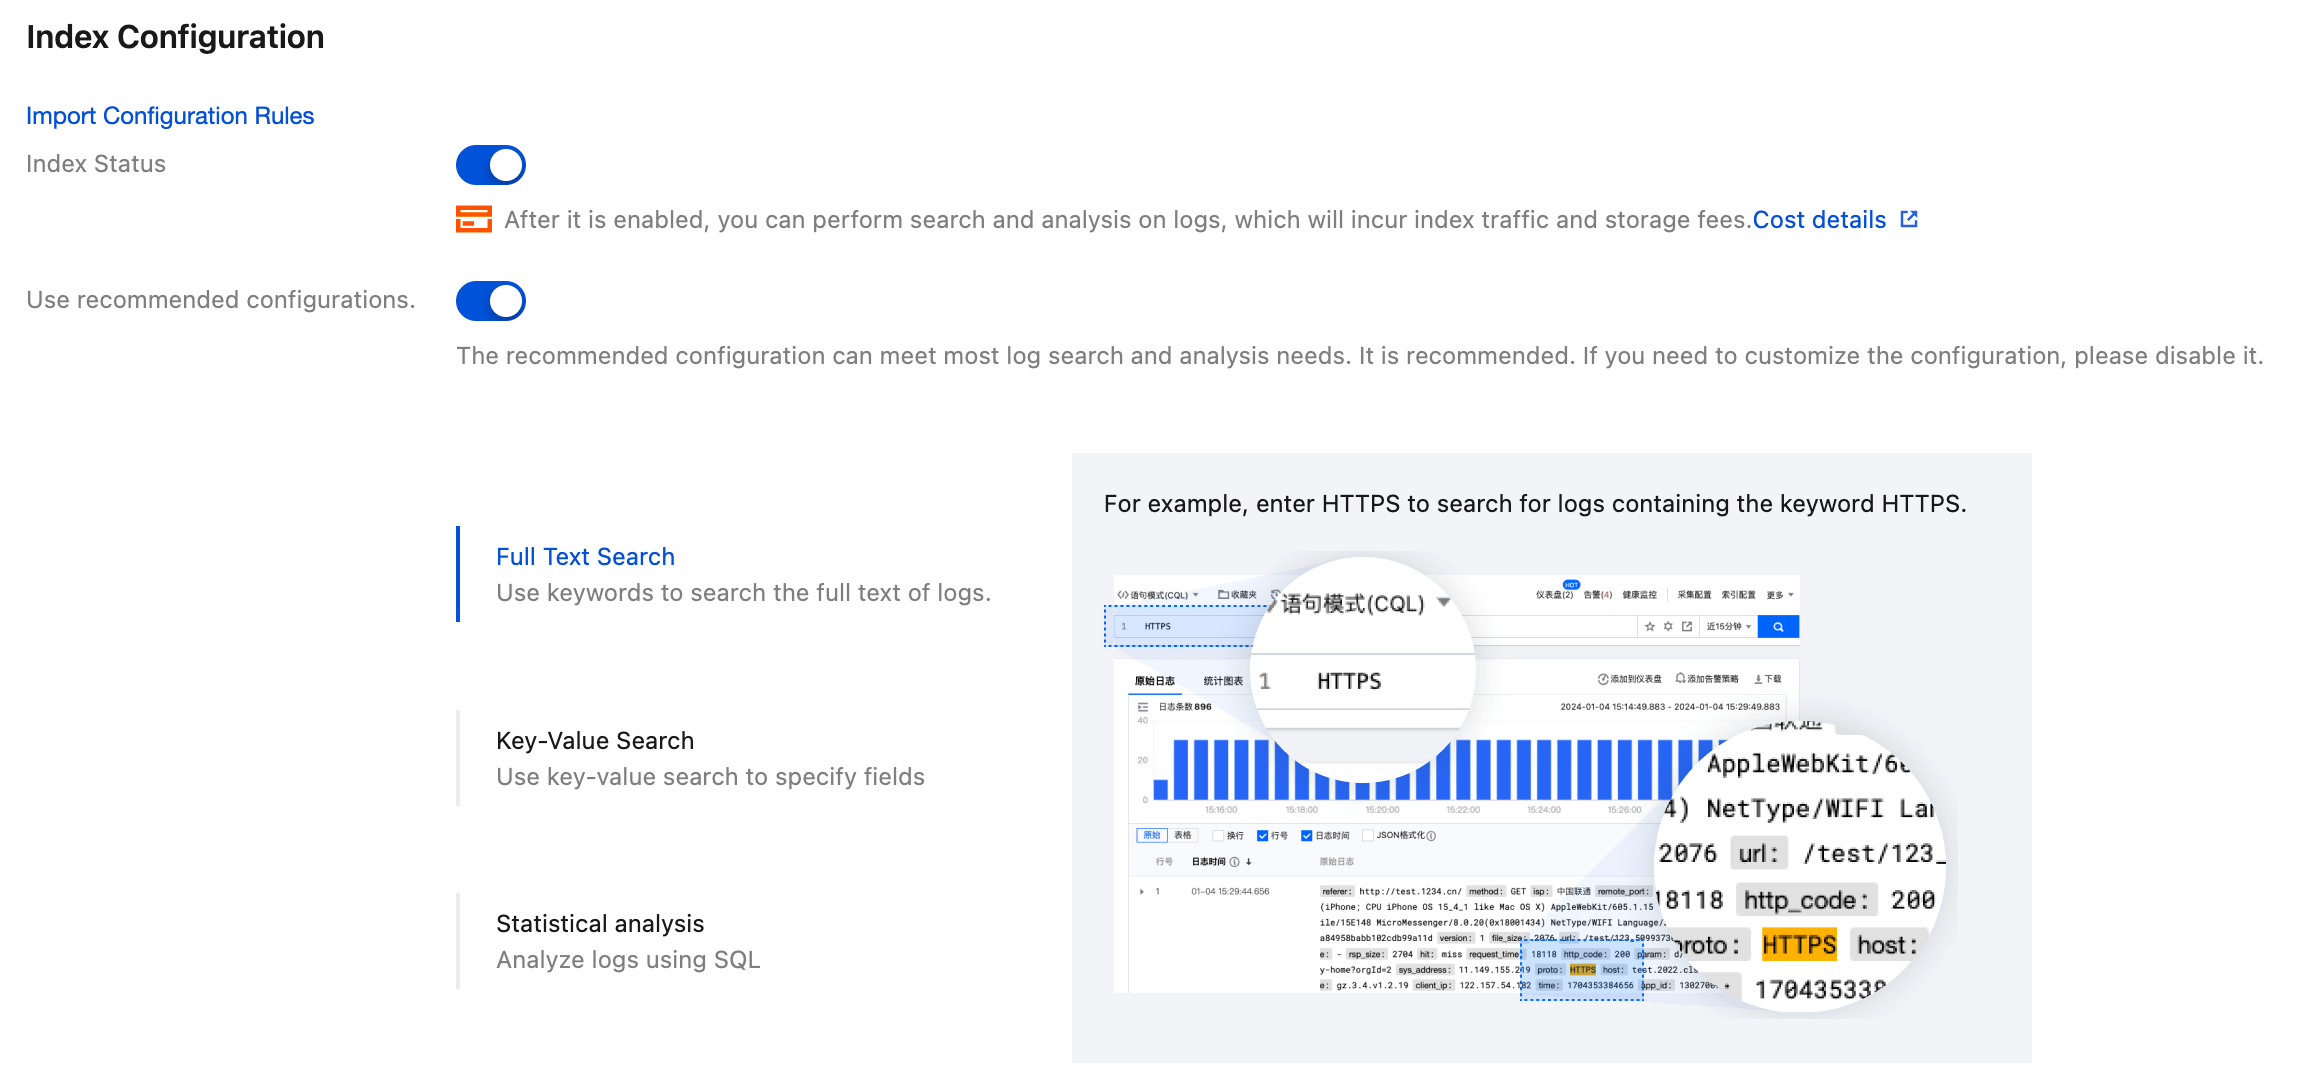
低頻度トピックは全文インデックスのみをサポートします。
インデックス設定のインポート
1. CLSコンソールにログインします。
2. 左側のナビゲーションバーでログトピックをクリックし、ログトピックリストページに移動します。
3. インデックスを設定する必要があるログトピックのID/名前をクリックし、ログトピック管理ページに移動します。
4. インデックス設定タブを選択し、設定ルールのインポートをクリックします。
5. ダイアログボックスで、インポートするログトピックのインデックス設定を選択し、OKをクリックして、選択したログトピックのインデックス設定を現在のログトピックのインデックス設定に入力します。
6. 内容に誤りがないことを確認した後、OKをクリックすると、現在のログトピックのインデックス設定を保存できます。
料金説明
仕様と制限
よくあるご質問
インデックス作成時に異常が発生するとはどういう意味ですか?__RAWLOG__および__INDEX_STATUS__とは何ですか?
ログのインデックス作成中に、元のログ形式が異常であるか、インデックス設定が元のログと一致しない場合、ログの
インデックス作成異常
が発生する可能性があります。このとき、CLSはログの損失を防ぐために、元のログを__RAWLOG__に保存します。これはフォールバックの異常処理方法です。__INDEX_STATUS__はインデックス作成異常の原因です。__RAWLOG__は全文検索のみをサポートし(全文インデックスを有効にする必要があります)、キー値検索、キー値インデックス、および統計分析はサポートしません。__INDEX_STATUS__は全文検索とキー値検索をサポートします。__INDEX_STATUS__:*を使用して、インデックス作成異常が発生したすべてのログを照会できます。説明:
異常が発生したログは、全文インデックスを有効にした後も、元のログ全文に基づいてインデックストラフィック、インデックスストレージ、および対応する費用が計算され、追加費用は発生しません。
インデックス作成異常には2種類の状況が含まれます:
1. 日志中所有的字段均未按照索引配置成功创建索引、此时日志中仅具备
__RAWLOG__字段、只能使用全文检索。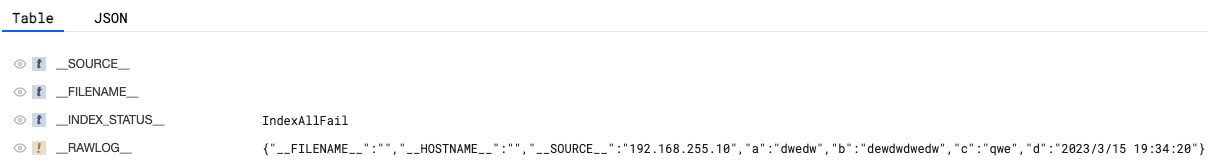
2. ログ内の一部のフィールドでインデックスの作成に失敗し、一部のフィールドではインデックスの作成に成功しました。このとき、ログには
__RAWLOG__フィールドと、インデックスの作成に成功した一部のフィールドの両方が存在します。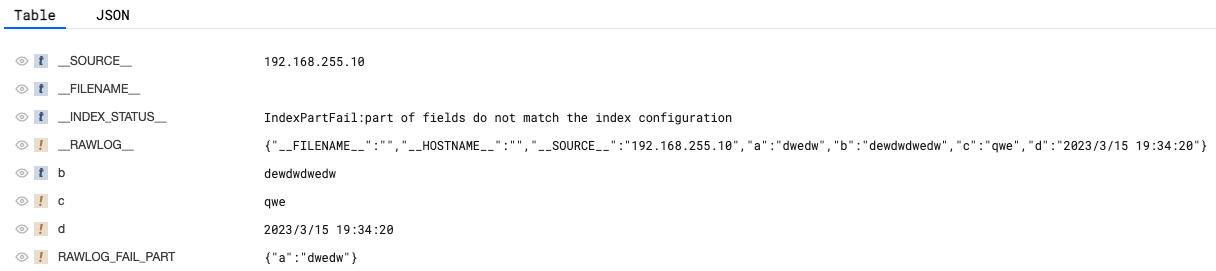
インデックス設定-詳細設定では、異常部分のフィールドを指定フィールドに保存することもできます(デフォルトはRAWLOG_FAIL_PARTで、キー値インデックスと統計分析の設定をサポートします)。
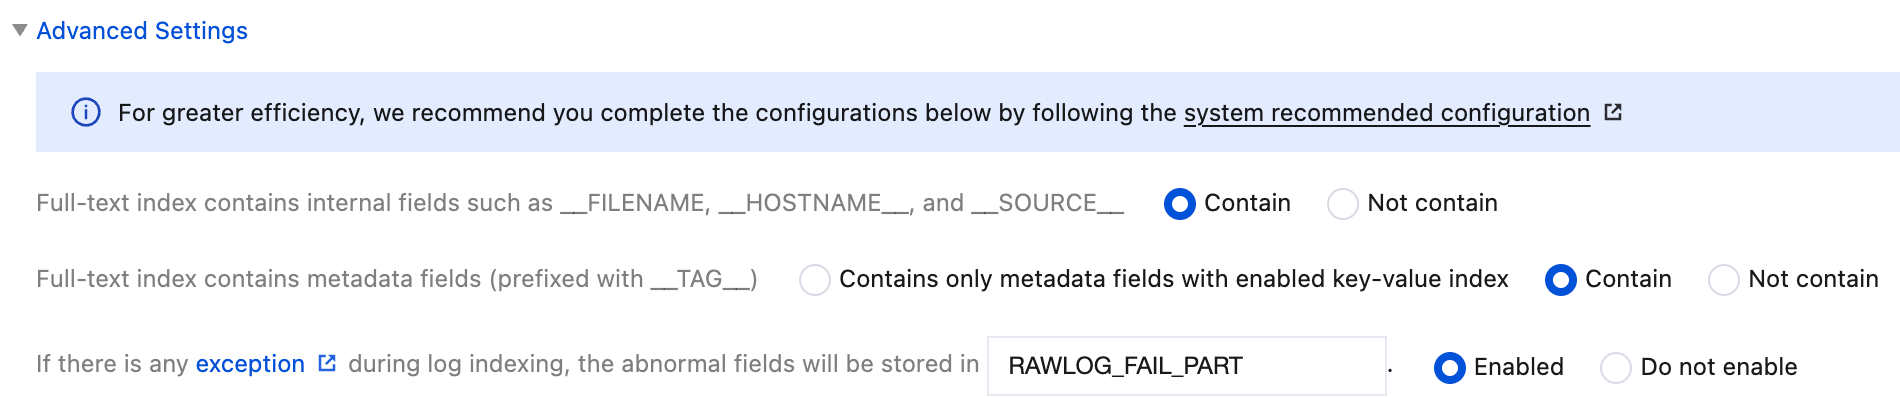
CLSはインデックス設定と元のログとの互換性を継続的に最適化し、上記の異常状況が発生しないように努めます。製品の反復アップグレードに伴い、具体的な異常処理ルールは変更される可能性があります。
フィードバック