データ加工の概要
ダウンロード
フォーカスモード
フォントサイズ
データ加工
は、ログデータのフィルタリング、クリーニング、マスキング、エンリッチメント、配信などの機能を提供します。データ加工のデータリンクにおける位置、source(データソース)およびsink(結果保存)の違いに応じて、現在以下のようなデータ処理のシナリオをサポートしています:
シナリオ | 説明 |
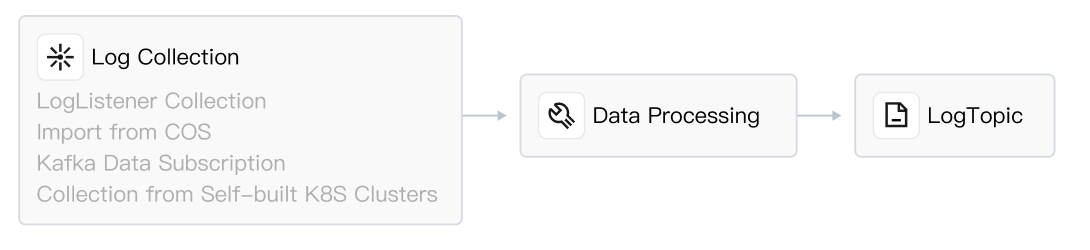 | ログ収集・加工・ログトピック: ログはCLSに収集され、まずデータ加工(フィルタリング、構造化)を経て、その後ログトピックに書き込まれます。図に示すように、データ加工はデータリンクにおいてログトピックの前に位置し、これを前置データ加工と呼びます。 前置データ加工でログフィルタリングを行うことで、ログ書き込みトラフィック、インデックストラフィック、インデックスストレージ量、ログストレージ量を効果的に削減できます。 前置データ加工でログ構造化を行い、キーバリューインデックスを有効にすると、SQLを使用してログの分析、ダッシュボードの設定、アラートの設定を行うことができます。 |
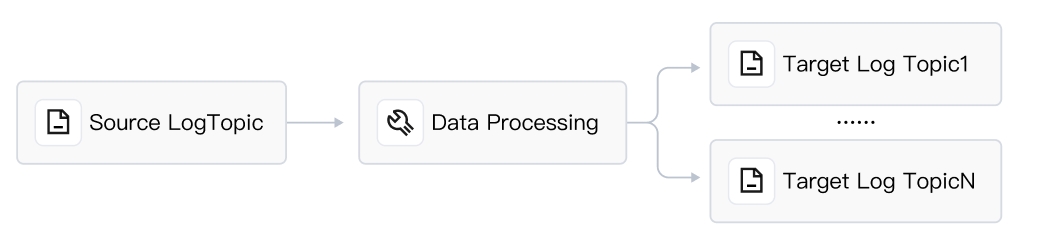 | ログトピック・加工・固定ログトピック: |
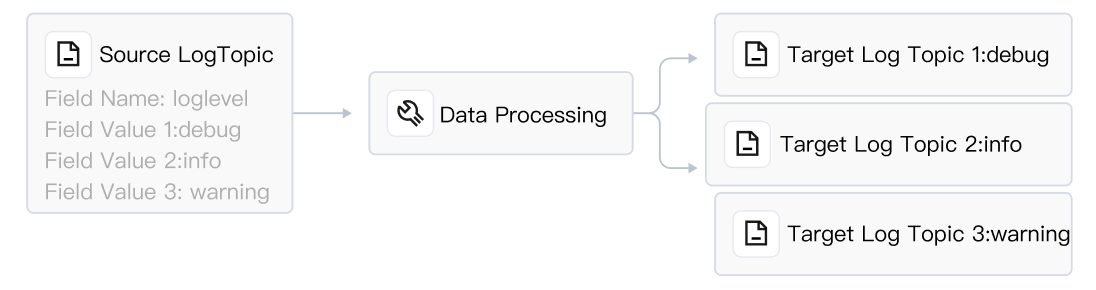 | ログトピック・加工・動的ログトピック: 元のログトピックのフィールド値に基づいて、ログトピックを動的に作成し、関連ログを対応するログトピックに配信します。例えば、元のログトピックにServiceというフィールドがあり、「Mysql」、「Nginx」、「LB」などの値がある場合、CLSはMysql、Nginx、LBなどの名前のログトピックを自動的に作成し、関連ログを上記のトピックに書き込むことができます。 |
基本的な概念
機能特性
構造化データの抽出を行います。これにより、後続のBI分析、監視グラフ(Dashboard)の生成などが容易になります。元のログが構造化データでない場合、SQL計算を実行できず、ログに対するOLAP分析、CLSダッシュボード(SQL結果に基づくグラフ描画)などの利用もできません。そのため、データ加工を使用して非構造化データを構造化データに変換することをお勧めします。ログに規則性がある場合は、ログ収集時に構造化データを抽出することもできます。詳細は完全正規表現形式(単一行)または区切り文字形式を参照してください。収集側と比較して、データ加工はより複雑な構造化処理ロジックを提供します。
ログフィルタリングを行います。これにより、後続の利用コストを削減できます。不要なログデータを破棄することで、クラウド上のストレージコストとトラフィックコストを削減できます。例えば、後続でログをTencent Cloud COS、Ckafkaに配信する場合、配信のトラフィックを効果的に削減できます。
機密データマスキング。例えば、身分証明書や携帯電話番号などの情報をマスキングします。
ログ振り分け。例えば、ログレベル:ERROR、WARNING、INFOに従ってログを分類し、異なるログトピックに振り分けます。
製品の強み
シンプルで使いやすく、データアナリストや運用保守エンジニアにとって特に扱いやすいです。すぐに利用可能な関数を提供しており、Flinkクラスタの購入、設定、運用保守は不要です。当社がパッケージ化したDSL関数を使用するだけで、クリーニングフィルタリング、マスキング、構造化、配信などの大量ログのストリーム処理を実現できます。詳細は関数概要を参照してください。
高スループットのリアルタイムログデータストリーム処理です。加工効率が高く(ミリ秒単位の処理遅延)、スループットが高く、10~20MB/秒/パーティション(ソースログトピックのパーティション)に達します。
導入事例
データクリーニングフィルタリング:顧客Aでは、無効なログを破棄し、指定されたフィールドのみを保持し、一部の欠落しているフィールドとフィールド値を補完します。ログにproduct_name、sales_managerフィールドがない場合、無効なログとみなしてそのログを破棄します。それ以外の場合はログを保持し、price、sales_amount、discountの3つのフィールドのみを保持します。その他のフィールドはdropし、そのログにdiscountフィールドが欠落している場合は、このフィールドを新規追加し、デフォルト値(例:「70%」)を割り当てます。
データ変換:顧客Bでは、元のログのフィールド値はIPアドレスです。顧客はIPに基づいて、国、都市のフィールドと値を追加する必要があります。例えば2X0.18X.51.X5の場合、フィールド国:中国、都市:北京を追加します。UNIXタイムスタンプを北京時間に変換します。例えば1675826327を2023/2/8 11:18:47に変換します。
ログ分類配信:顧客Cでは、元のログは多層JSONであり、JSONにはArray配列も含まれています。顧客Cはデータ加工を使用して、多層JSONの指定ノードの配列を抽出してフィールド値とします。例えば、Array[0]からAuthフィールドの値を抽出し、そのAuthフィールドの値に基づいてログデータを振り分けます。値が「SASL」の場合はターゲットトピックAに配信し、値が「Kerberos」の場合はターゲットトピックBに配信し、値が「SSL」の場合はターゲットトピックCに配信します。
ログ構造化:顧客Dでは、元のログ
「2021-12-02 14:33:35.022 [1] INFO org.apache.Load - Response:status: 200, resp msg: OK」をデータ加工によって構造化し、その結果は log_time:2021-12-02 14:33:35.022, loglevel:info, status:200となります。料金説明
データ加工には関連費用が発生します。詳細は課金概要を参照してください。業務で加工後のログのみを使用する場合は、ソースログトピックの保存期間を3~7日に設定し、ソースログトピックのインデックスを有効にしないことをお勧めします。これにより、費用を効果的に削減できます。
仕様と制限
フィードバック