TKEイベントログ分析
ダウンロード
フォーカスモード
フォントサイズ
概要
Tencent Kubernetes Engine(TKE)は、Tencent Cloudが提供する高性能でスケーラブルなコンテナ管理サービスであり、ユーザーがコンテナ化アプリケーションを容易にデプロイおよび管理できるよう支援します。TKEの使用中、クラスタ内ではノード状態の異常やPodの再起動など、さまざまな状況が次々と発生し、変化も予測できません。状況をいち早く感知できない場合、問題対応の最適なタイミングを逃す可能性があり、問題が拡大してビジネスに影響を及ぼしてから気づいた時には、すでに手遅れになっていることが少なくありません。この問題を解決するため、CLSはTKEと緊密に統合され、クラスタイベントログをリアルタイムでCLSに収集することをサポートしています。同時に、CLSの強力なログ分析および検索能力を活用することで、ユーザーはクラスタの稼働状況を包括的に監視し、問題の根本原因を迅速に特定し、障害対応の効率を向上させることができます。例:
あるPodが頻繁に再起動する場合、ユーザーはイベントログを通じてその状態変化を追跡し、問題の原因を迅速に特定できます。
ノードに異常が発生した場合、イベントログは詳細なコンテキスト情報を提供し、ユーザーがノードの再起動や交換が必要かどうかを判断するのを支援します。
ユーザーはアラートルールを設定し、異常イベントの通知をタイムリーに受け取り、クラスタの安定性とビジネスの継続性を確保できます。
本実践を通じて、以下の内容を詳細に理解できます:
以下のデモを通じて、CLSとTKEの強力な連携をすぐに体験することもできます:
イベント総覧:時間、名前空間、レベル、原因、リソースタイプ、リソースオブジェクトなどの次元でイベントをフィルタリングし、主要イベントの集計統計情報を表示できます。
異常イベント集約検索:特定の期間内における各種異常イベントのreasonとobjectの分布傾向を表示します。
機能メリット
CLSはTKEイベントログ分析シナリオ向けに、すぐに利用できるイベント分析ダッシュボードを提供します。ダッシュボードには、異常イベントレベル分布、異常イベント原因分布、異常リソースオブジェクト分布などの分析ボードが含まれます。
TKEイベントログの収集
ステップ1:TKEクラウド製品センターに入る
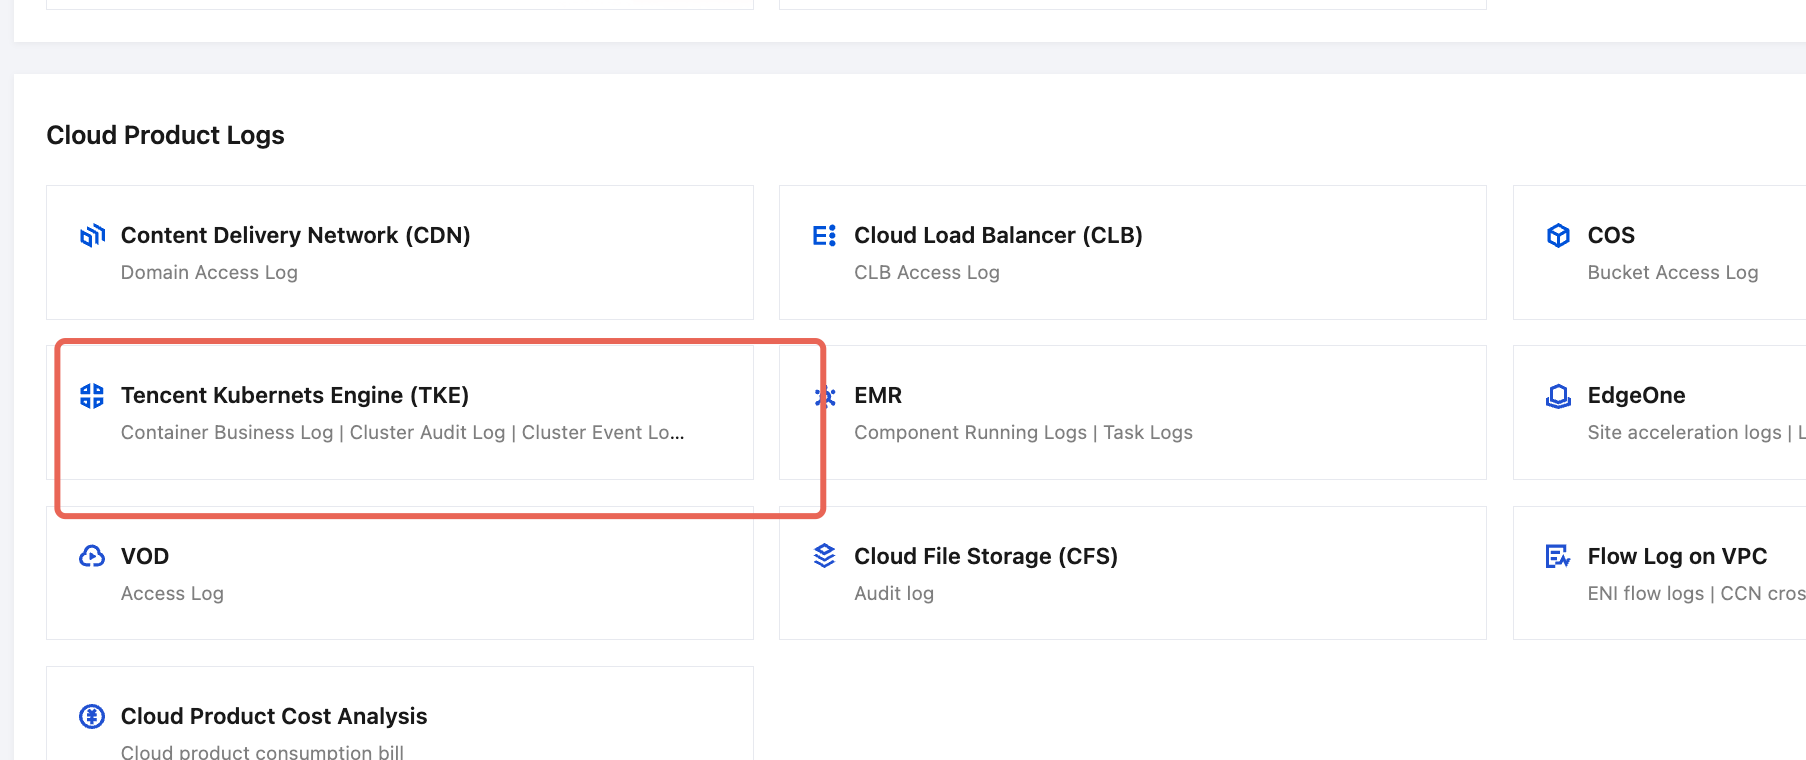
1. ログサービスコンソールにログインし、左側のナビゲーションバーでクラウド製品センターを選択し、クラウド製品センターページに入ります。
2. クラウド製品ログでTKEを見つけ、クリックしてTKEクラウド製品センターに入ります。
ステップ2:TKEクラスタイベントログ収集を有効にする
1. アクセス管理 > インスタンスアクセスページを選択します。
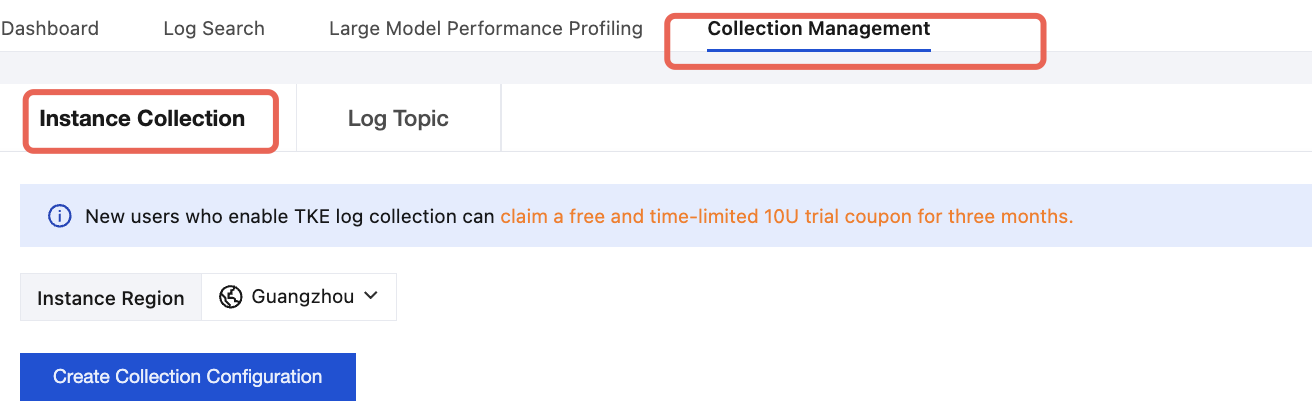
2. TKEクラウド製品センターで、クラスタリストからターゲットクラスタを見つけます。収集コンポーネントの状態が未インストールの場合は、インストールをクリックして、ログ収集コンポーネントをインストールします。
注意:
ログ収集コンポーネントをインストールすると、クラスタのkube-system名前空間に、DaemonSetとしてtke-log-agentのpodとcls-provisionerのpodが1つずつデプロイされます。各ノードに少なくとも0.1コア、16Mib以上の利用可能なリソースを予約してください。
3. 収集コンポーネントの状態が最新の場合は、クラスタ名をクリックしてクラスタ詳細ページに入り、クラスタ詳細ページのログ管理でクラスタイベントログを見つけます。
4. クラスタイベントログをクリックして有効にし、クラスタイベントログ設定プロセスに入ります。
5. イベントログ設定プロセスに入り、ログトピック設定ステップで、ログ保存用の既存ログトピックを選択するか、新しく作成できます。ログトピックの関連情報については、ログトピックを参照してください。
6. ログトピックの設定が完了したら、次へをクリックしてインデックス設定に進みます。インデックスの関連情報については、インデックスを参照してください。
インデックス設定の設定情報は以下の通りです:
インデックス状態:インデックスを有効にするかどうかを確認し、ログ検索などの分析機能を使用します。
全文インデックス:大文字と小文字を区別するかどうかを確認します。全文トークナイザ:デフォルトは「@&()='",;:<>[]{}/ \\n\\t\\r」です。変更するかどうかを確認します。
中文が含まれているかどうか:有効にするかどうかを確認します。
キー値インデックス:key名に基づいて、フィールドタイプ、トークナイザ、統計分析を有効にするかどうかを必要に応じて設定できます。キー値インデックスを有効にする必要がある場合は、スイッチをオンにしてください。
注意
検索を有効にするにはインデックス設定をオンにする必要があります。オンにしない場合は検索できません。
ログフィールドに基づいてログを検索する必要がある場合は、キー値インデックスを設定する必要があります。
ログフィールドに基づいて統計分析を行う必要がある場合は、キー値インデックスを設定し、統計を有効にする必要があります。
インデックスルール編集後は新しく書き込まれたログにのみ適用され、既存データは更新されません。
TKEイベント分析ダッシュボードの表示
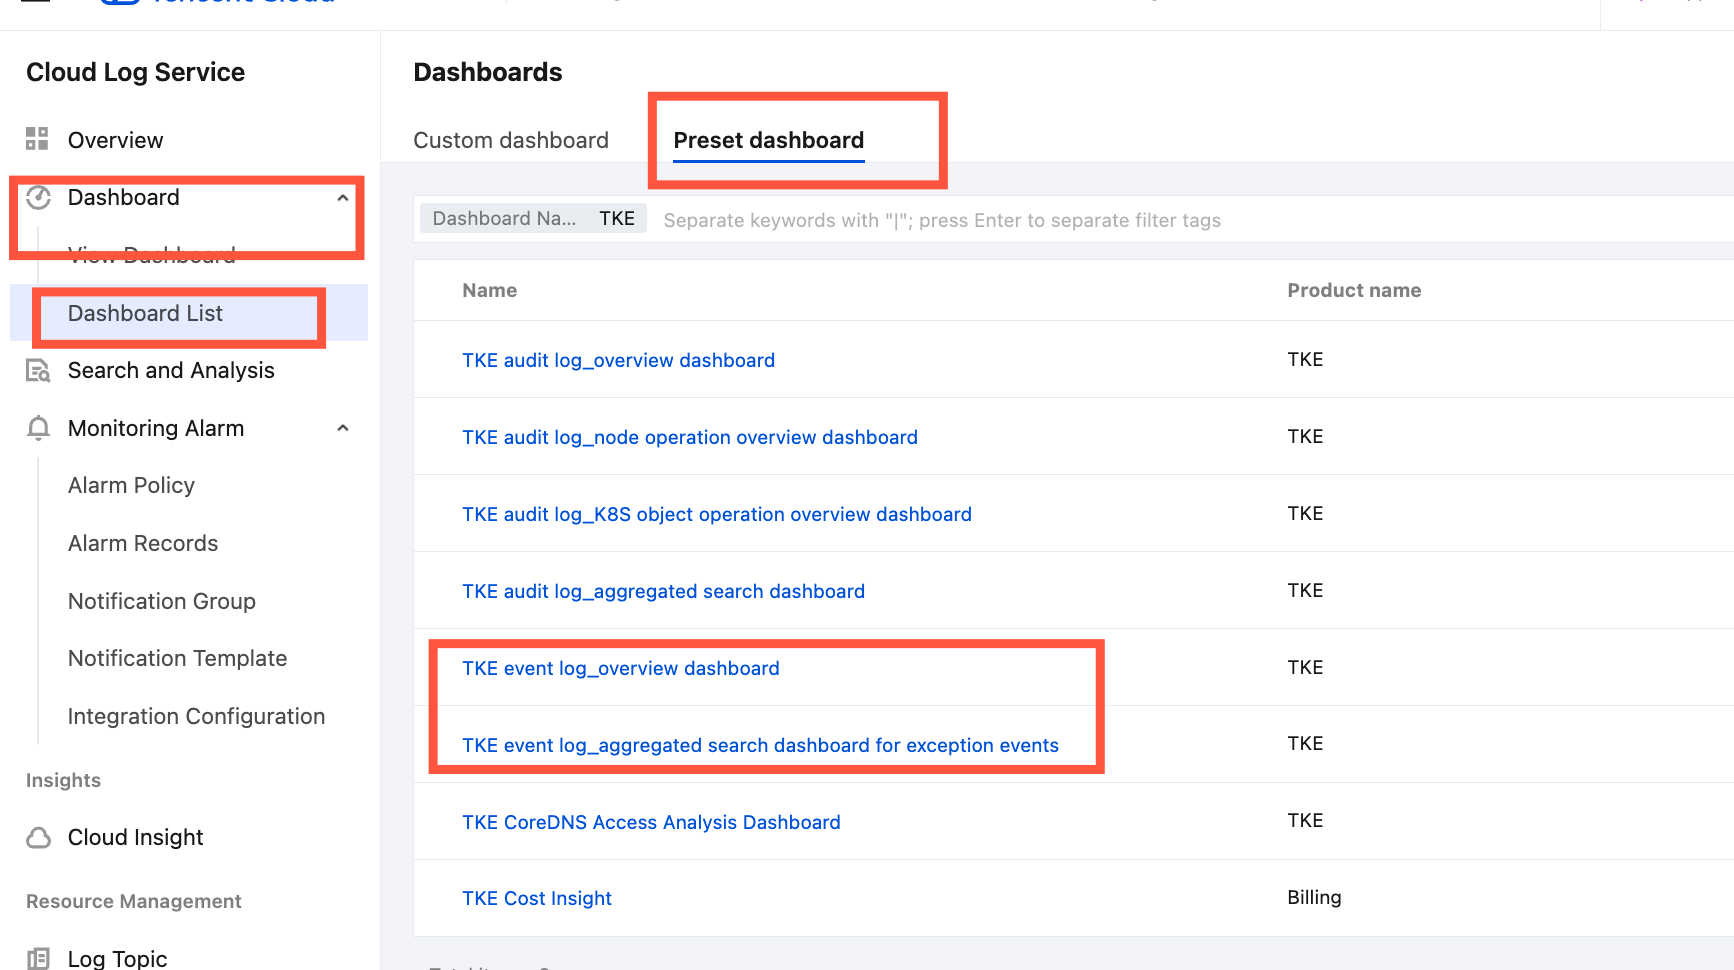
TKEイベントログ収集を有効にすると、CLSはTKEイベントシーン向けに、すぐに利用できる2種類のプリセットダッシュボードを提供します。
イベント総覧:時間、名前空間、レベル、原因、リソースタイプ、リソースオブジェクトなどの次元でイベントをフィルタリングし、主要イベントの集計統計情報を表示できます。
異常イベント集約検索:特定の期間内における各種異常イベントのreasonとobjectの分布傾向を表示します。
以下の操作で上記のTKEイベントプリセットダッシュボードを表示できます:
1. CLSコンソールにログインします。
2. 左侧のナビゲーションバーで、ダッシュボード>ダッシュボードリスト>プリセットダッシュボードを選択し、「TKE イベントログ」を検索します。
クラスタイベントログの検索・分析
1. TKEイベントログ収集を有効にすると、クラスタリストでクラスタイベントログが有効になっているクラスタを見つけ、クラスタ名をクリックしてクラスタ詳細ページに移動します。
2. クラスタ詳細ページでログ管理を選択し、クラスタイベントログモジュールを見つけます。
3. イベントログをクリックすると、ログ検索ページに移動し、対象クラスタのイベントログを検索分析できます。ログフィールドの説明については、ログフィールドの説明をご参照ください。
ログフィールドの説明
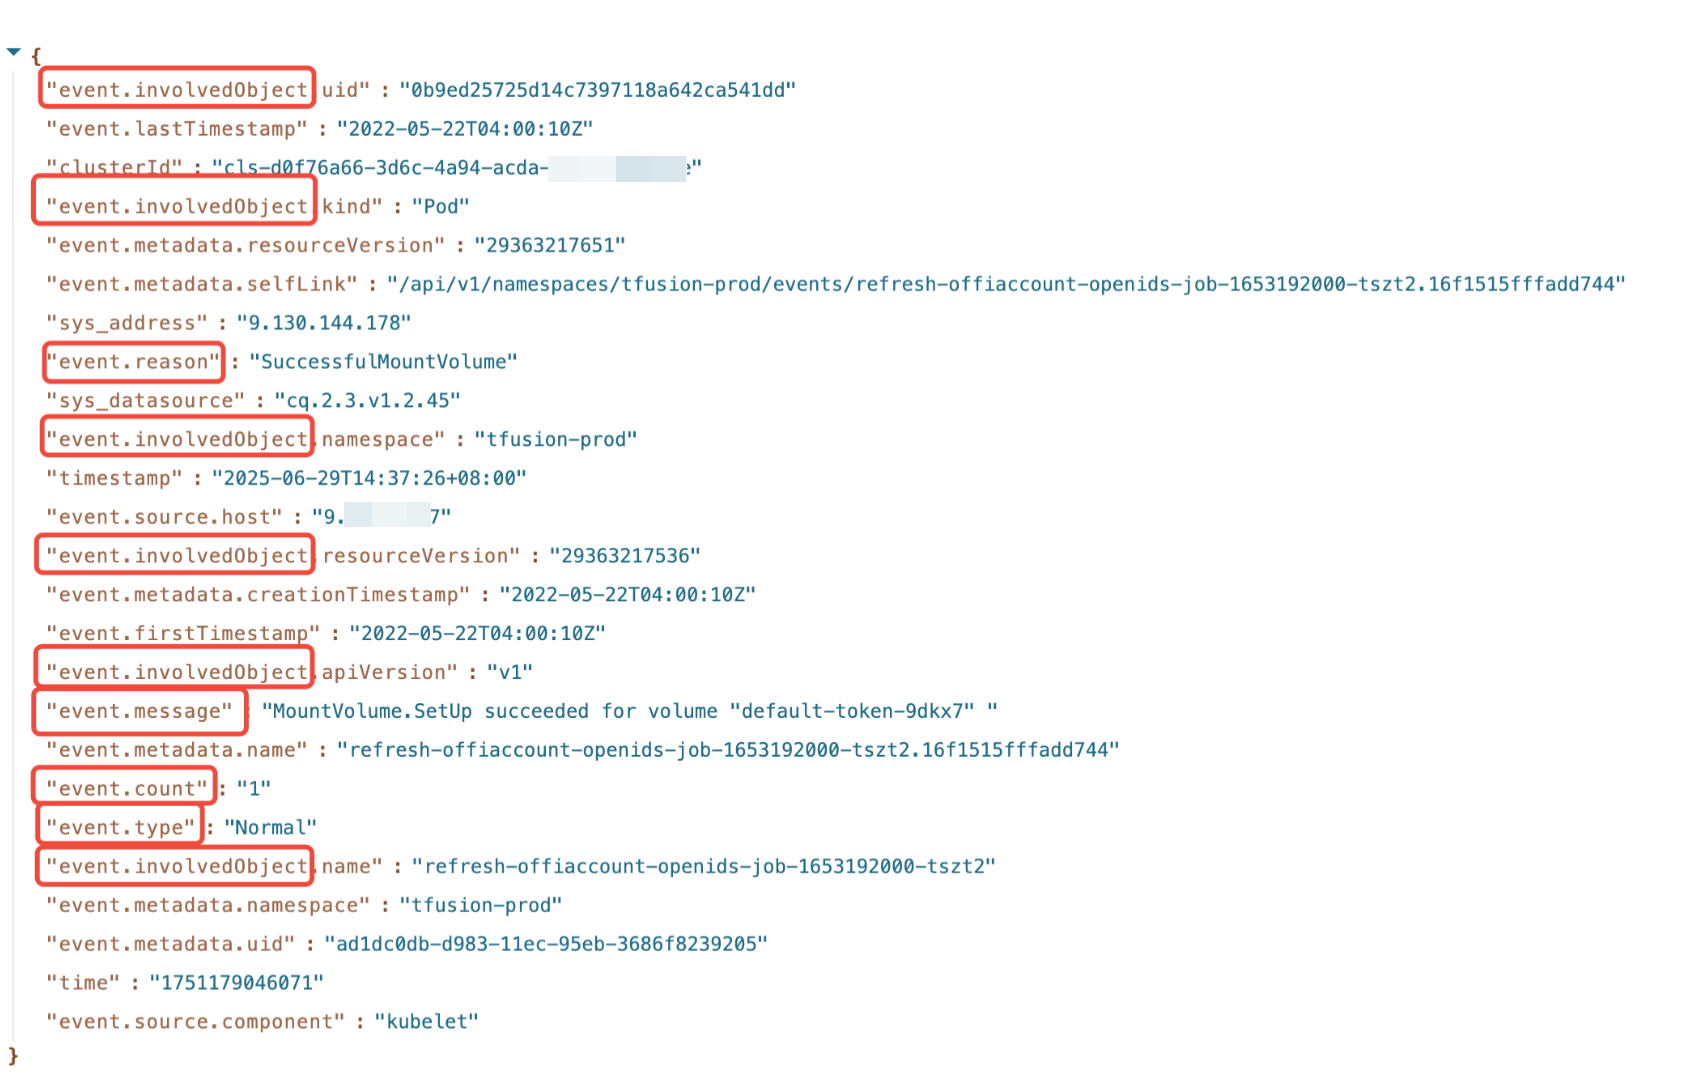
レベル(Type):現在は「Normal」と「Warning」のみですが、必要に応じてカスタムタイプを使用できます。
リソースタイプ/オブジェクト(Involved Object):イベントに関係するオブジェクトです。例えば、Pod、Deployment、Nodeなどです。
イベントソース(Source):このイベントを報告するコンポーネントです。例えば、Scheduler、Kubeletなどです。
内容(Reason):現在発生しているイベントの短い説明で、一般的には列挙値であり、主にプログラム内部で使用されます。
詳細説明(Message):現在発生しているイベントの詳細な説明情報です。
出现回数(Count):イベントが発生した回数です。
実践シナリオ事例
シーン1:Nodeノードに異常が発生した場合の原因特定
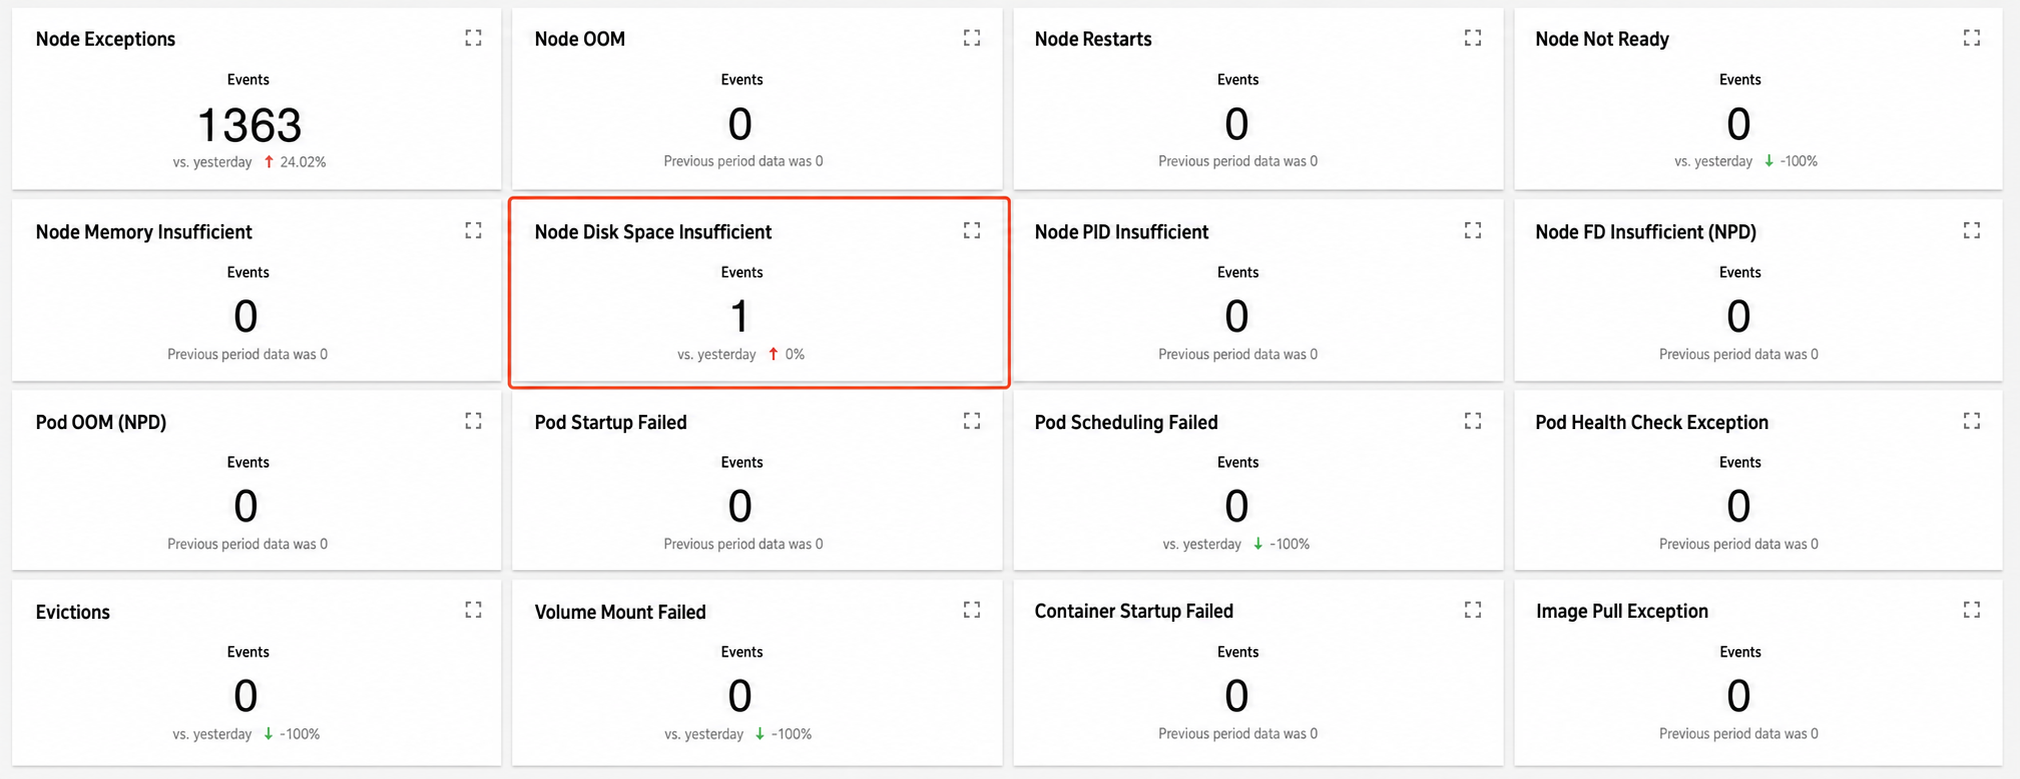
1. TKE イベント分析ダッシュボードの表示を参照して、イベント概要ダッシュボードを開き、リソースオブジェクトに異常ノード名を入力します。
2. 查询结果显示、ノードのディスク容量不足が1件あります:
シーン2:ノードのスケールアウトが発生したため、ユーザーは拡張プロセスを遡及して具体的な原因を特定する
ノードプールで「弹性伸缩」を有効にしたクラスタでは、CA(cluster-autoscaler)コンポーネントが負荷状況に応じてクラスタ内のノード数を自動的に増減します。クラスタ内のノードで自動拡張(縮小)が発生した場合、ユーザーはイベント検索を通じて拡張(縮小)プロセス全体を遡及できます。
1. TKE イベントログの検索分析を参照して、TKE イベントログ検索ページに移動します。
2. イベント検索ページで、以下の検索コマンドを入力します:
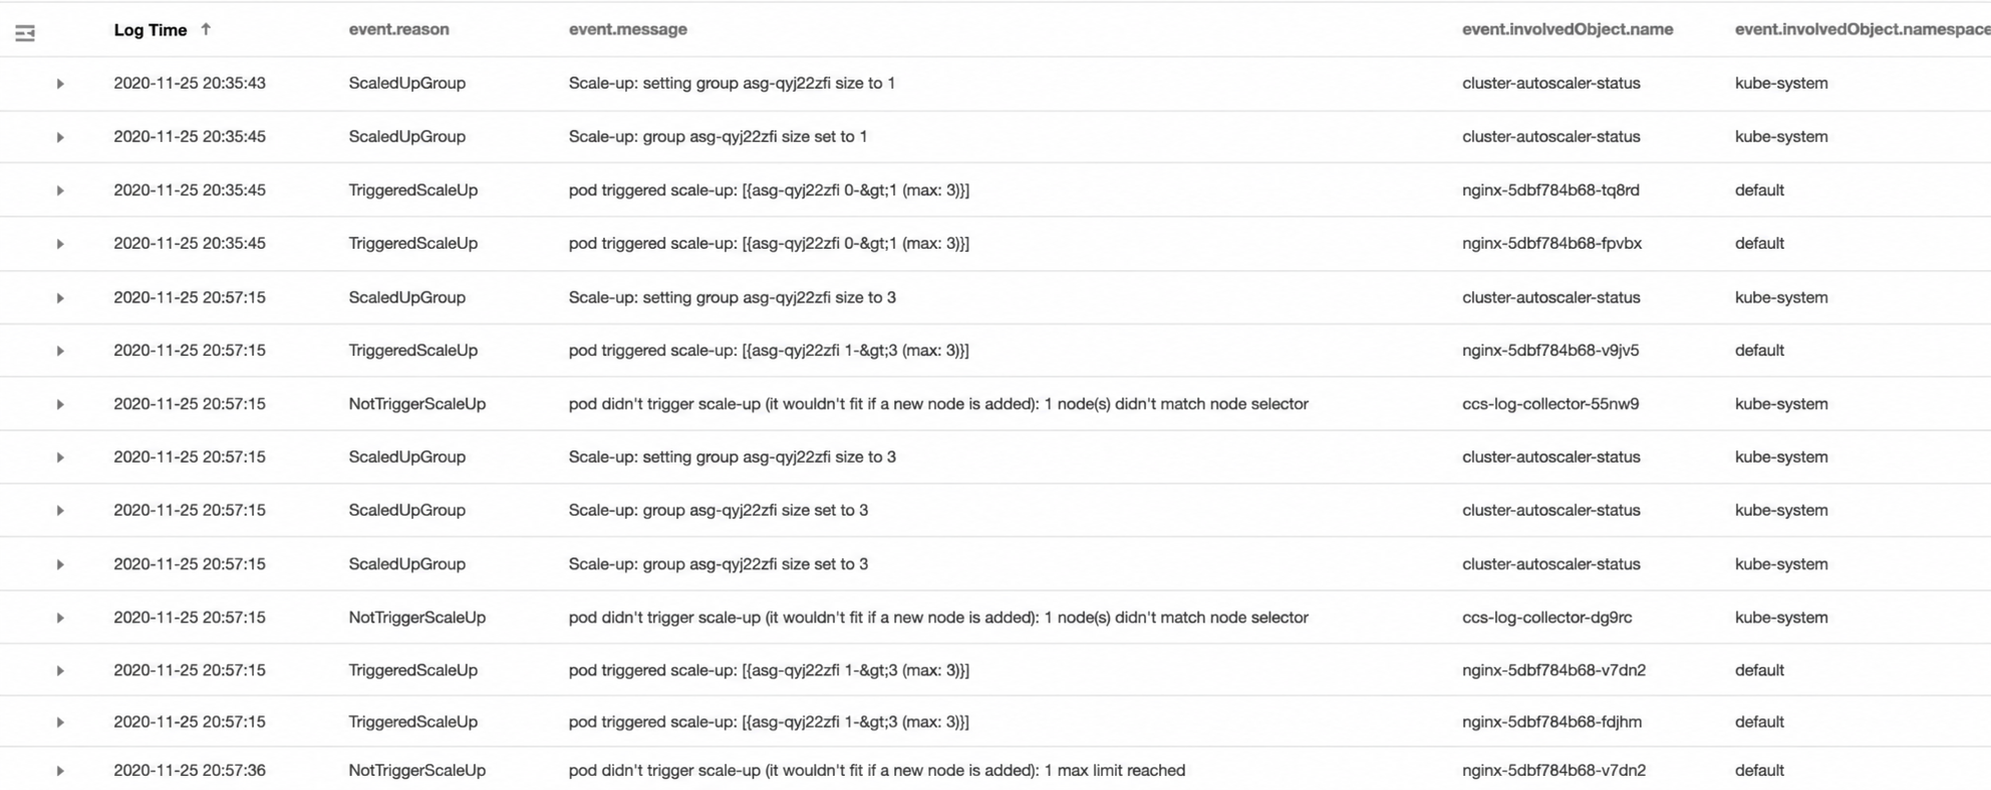
event.source.component : "cluster-autoscaler"
3. 結果は下図の通りです:
上図のイベントフローから、ノード拡張操作は
2020-11-25 20:35:45頃に、それぞれ3つのnginx Pod(nginx-5dbf784b68-tq8rd、nginx-5dbf784b68-fpvbx、nginx-5dbf784b68-v9jv5)によってトリガーされ、最終的に3つのノードが追加されました。その後の拡張は、ノードプールの最大ノード数に達したため、再トリガーされませんでした。フィードバック